一、什么是低代码平台
低代码(Low-Code)开发平台,指的是通过可视化拖拽、模型驱动和少量手写代码,就能快速搭建并部署应用的开发工具。Forrester 在 2014 年首次提出这个概念,将其定义为“让人们可以用最少的手工编码就可以快速开发应用,并可以快速配置和部署的一种技术和工具”;Gartner 进一步把它上升为企业低代码应用平台(LCAP),强调它应具备响应式 UI、页面与业务流程编排、内置数据库以及一键部署等能力(Zoho Creator《低代码平台的六大核心能力》)。
理解低代码的关键,是抓住它和两个相邻概念的区别。
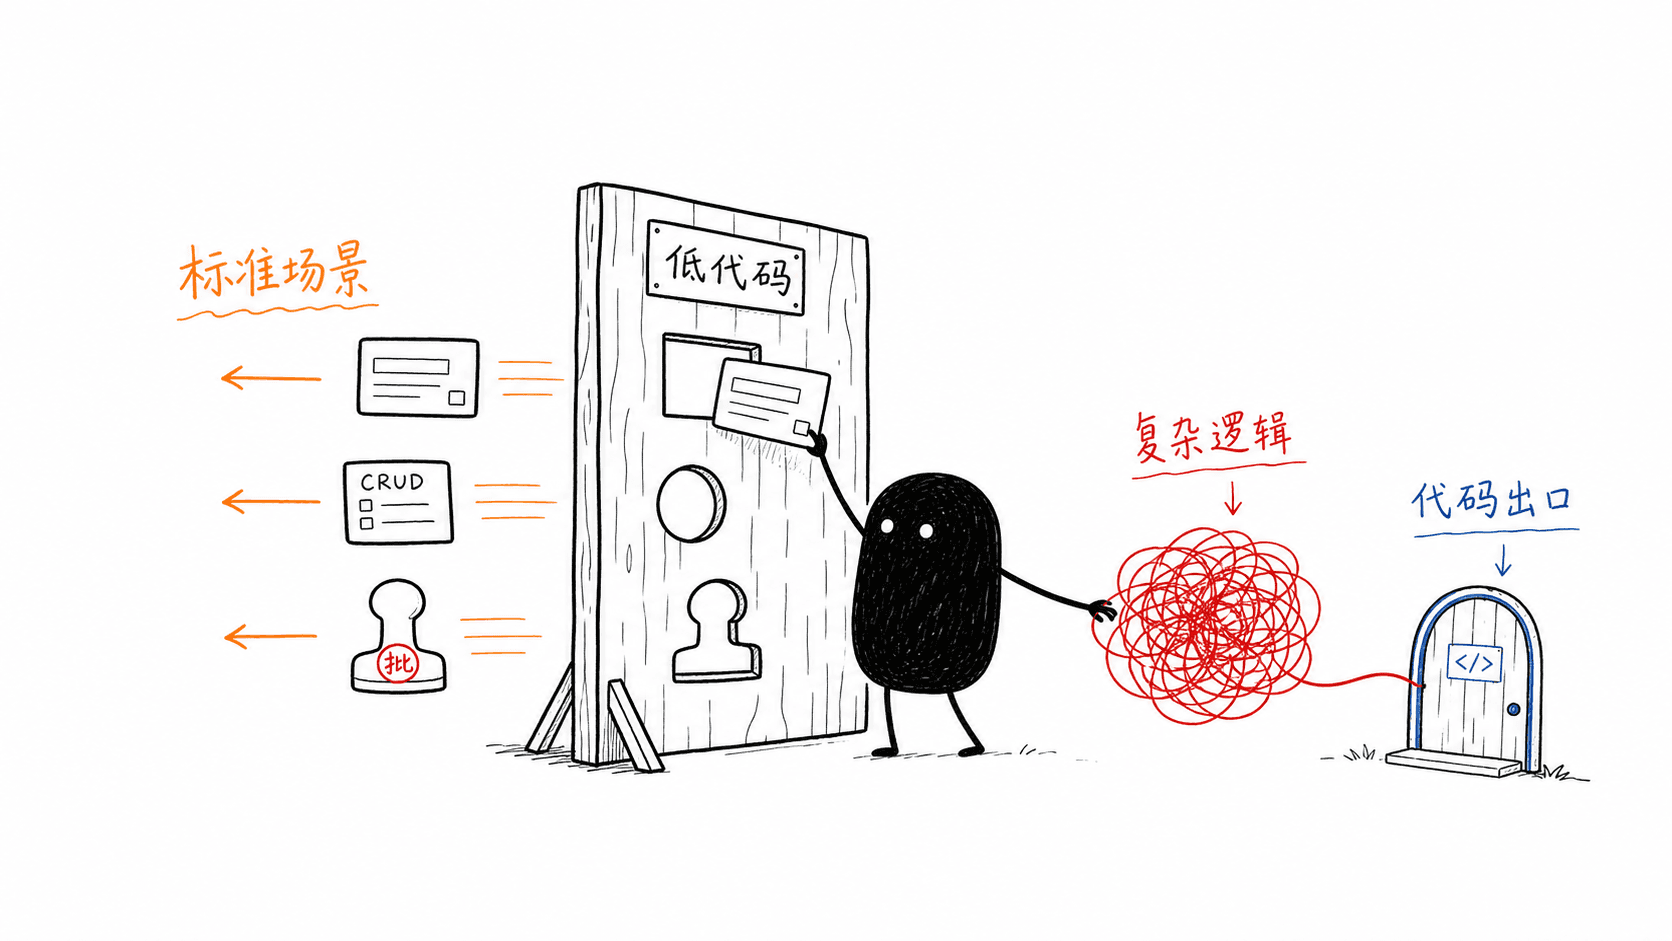
低代码不等于零代码。零代码面向完全没有技术背景的业务人员,靠纯配置完成中小型应用,定制能力弱;低代码则保留代码扩展能力,用可视化配置覆盖大约 80% 的开发工作,剩下 20% 的复杂逻辑仍然可以通过脚本或原生代码处理。这让它既能快速响应业务需求,又能撑住企业级系统的复杂度(Zoho Creator《低代码平台的六大核心能力》)。
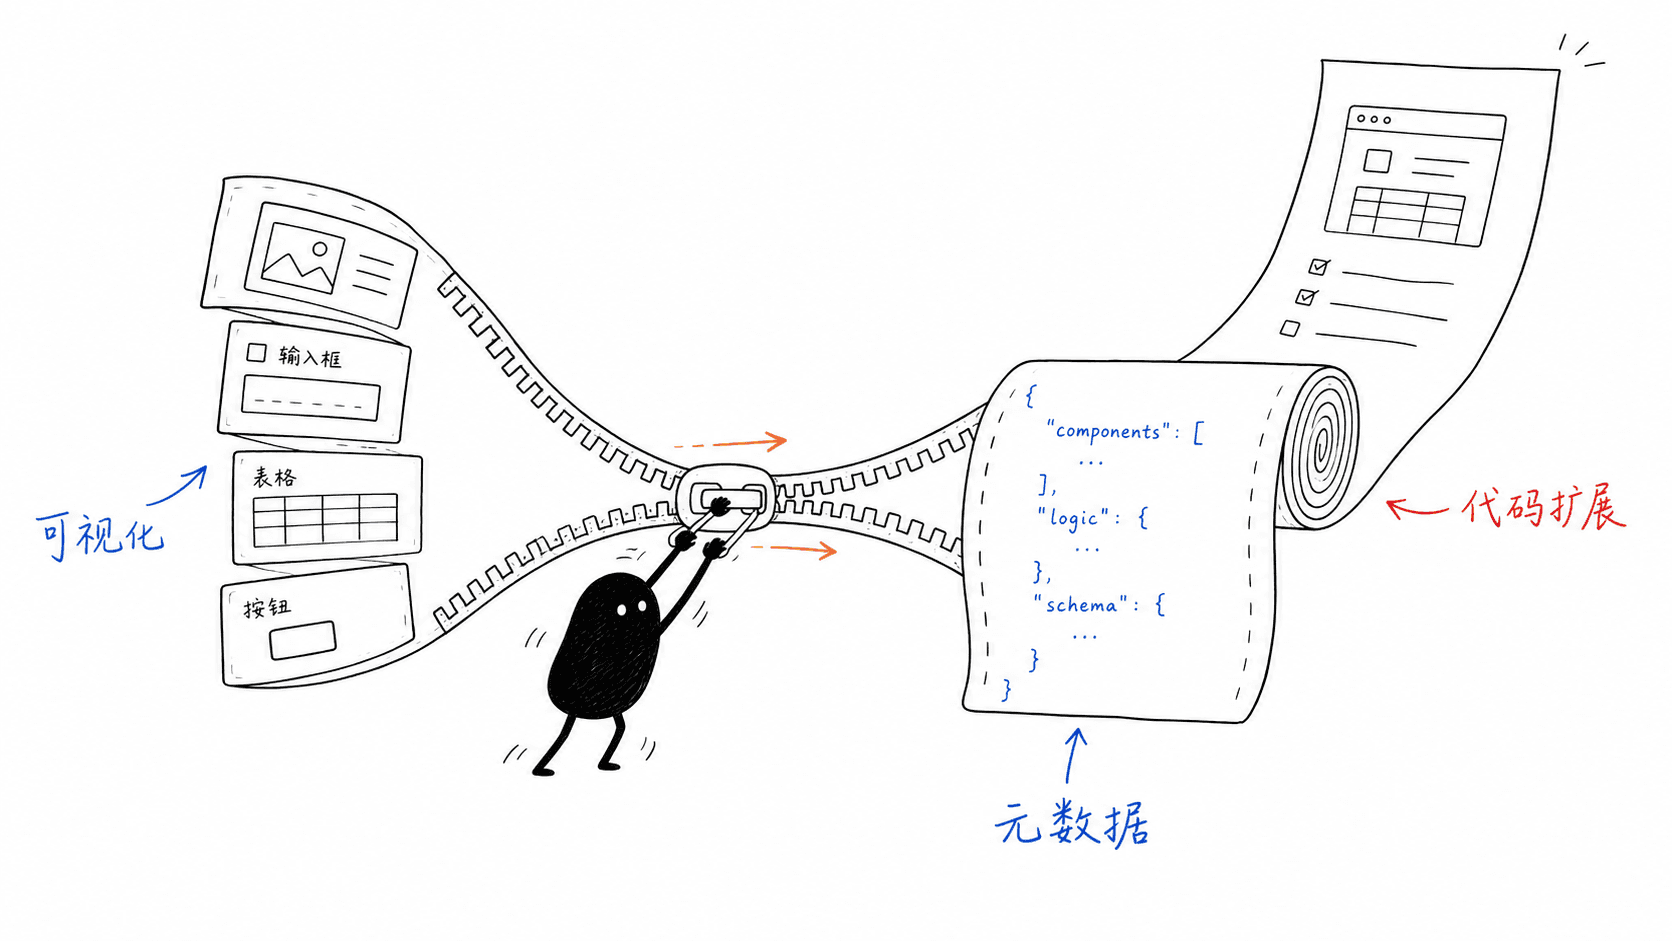
低代码也不等于传统的代码生成器。代码生成器是一次性产出源码、之后脱离平台维护;低代码平台的核心是元数据驱动——可视化设计的结果被保存为结构化的元数据(通常是一份 JSON Schema),运行时由渲染引擎解析这份元数据来生成可运行的软件,整个生命周期都围绕元数据展开(葡萄城《低代码平台的技术原理》)。
Gartner 给出了一个判断标准:一个产品算不算真正的低代码平台,要看它是否提供模型驱动、可视化开发、表达式语言、测试与版本控制等软件工程支持,能否集成外部系统,以及是否提供专业编程语言扩展能力。市面上很多号称低代码的产品,其实达不到这个门槛(Zoho Creator《低代码平台的六大核心能力》)。
二、核心架构:四层结构
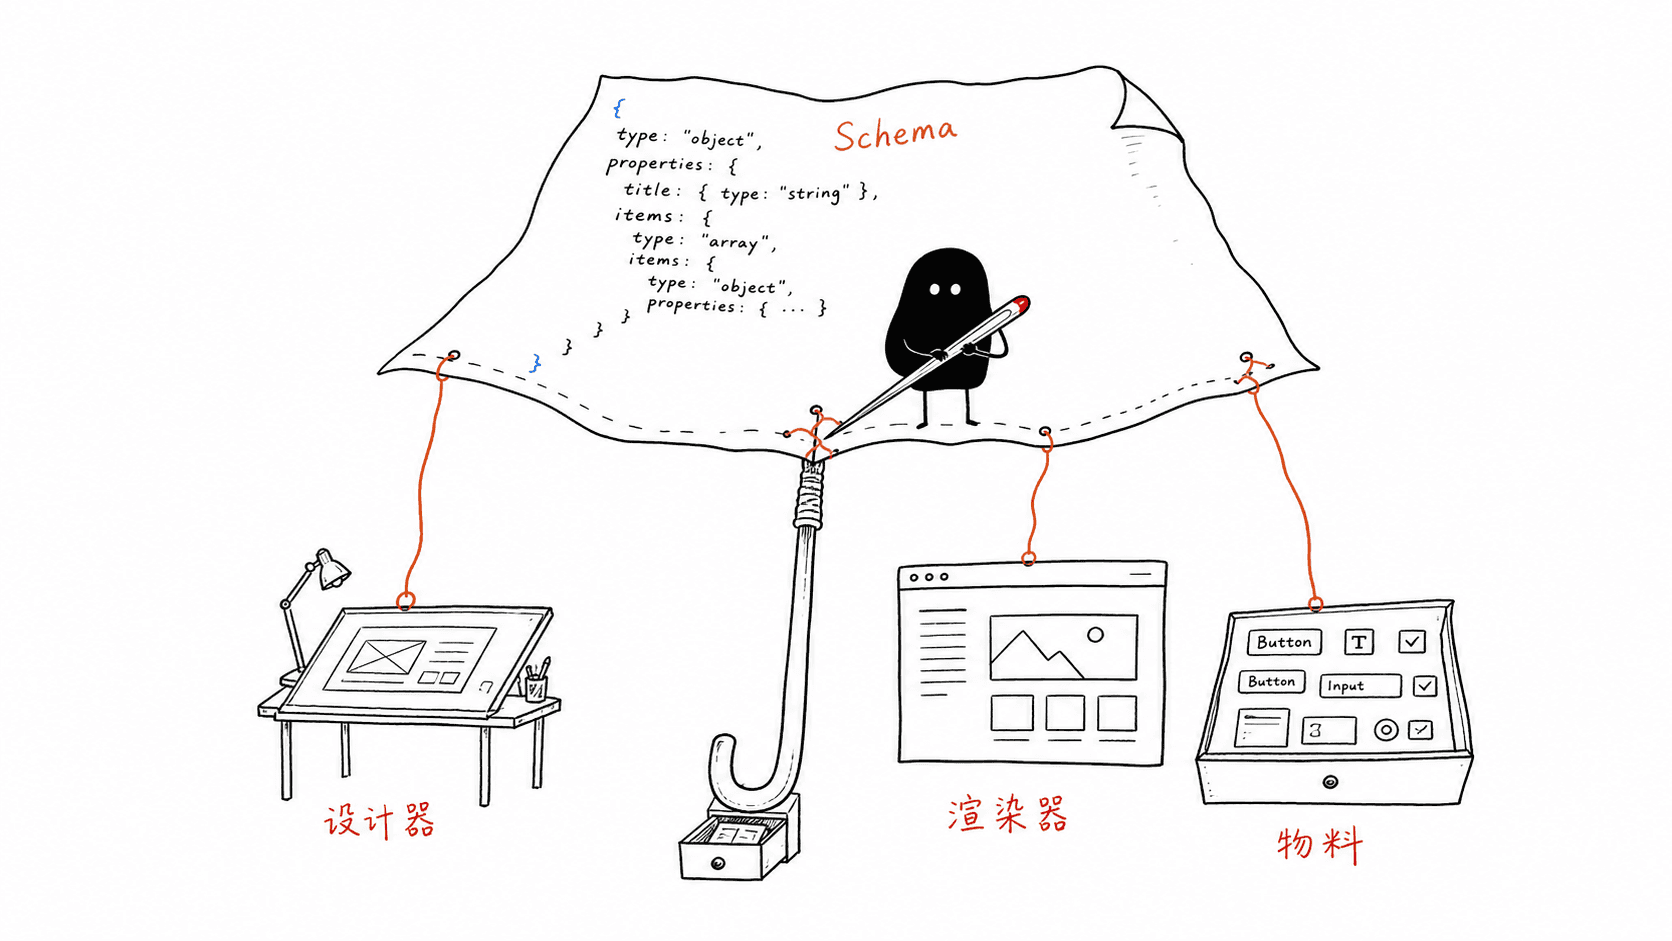
无论具体产品形态如何,一个完整的低代码平台在架构上基本可以拆成四层(腾讯《前端架构设计优化:构建可扩展的低代码平台》)。
页面描述协议(Schema / DSL) 是整个平台的中枢。它是一份声明式的数据结构,用 JSON 描述页面上有哪些组件、它们的嵌套关系、属性取值、事件绑定和样式。设计器产出它,渲染引擎消费它,后端存储它——所有模块都围绕这份数据协作。协议设计得好不好,直接决定了平台的可扩展性。
设计器(Designer) 是用户搭建页面的可视化环境,也是平台建设最耗精力的部分。它承载着入料(把物料导入可用列表)、编排(拖拽组件形成组件树)、组件配置(设置属性、样式、事件)、画布渲染等核心功能(LowCodeEngine《低代码引擎介绍》)。一个好的设计器要让业务人员能“所见即所得”地操作,同时给专业开发者留出深入配置的入口。
渲染引擎(Renderer) 是协议的消费者,负责把 Schema 解析成真实运行的页面。它要在设计态和运行态都能工作:设计态下支持拖拽、选中、hover 高亮等交互;运行态下只做纯粹的渲染和事件响应。
物料体系(Materials) 是可复用的组件库。低代码平台里的物料和普通前端组件的差别在于,它除了组件本身的实现,还需要附带描述信息——组件名称、截图、logo、哪些属性可以配置、配置项的展示形式(输入框、下拉、颜色选择器等)。这些元信息让设计器知道如何展示和编辑一个组件(CROOT《低代码平台技术架构详解》)。
三、前端工程化知识
1. 页面描述协议的设计
协议是低代码平台的灵魂,它的设计有几个核心考量。
组件树的描述通常采用嵌套的 JSON 结构,每个节点描述一个组件实例,包含组件类型、唯一标识、子节点列表。一个典型的 Schema 大致长这样:
{
  "componentName": "Page",
  "id": "node_1",
  "children": [
    {
      "componentName": "Button",
      "id": "node_2",
      "props": { "text": "提交", "type": "primary" }
    }
  ]
}
属性与事件的绑定是协议的难点。属性值不能只支持静态字符串,还得能绑定到变量、表达式、数据源字段;事件要能描述“点击时调用哪个接口、传什么参数、成功后做什么”。这往往需要设计一套表达式语言或数据绑定语法。
协议的版本化容易被忽视但很关键。随着平台迭代,协议结构会演进,旧页面保存的 Schema 需要在新版本渲染引擎里仍然能正确解析。常见的做法是在 Schema 根节点带上版本号,渲染引擎内部做兼容迁移。
腾讯在分享其低代码平台架构时强调,协议设计是决定可扩展性的第一步——它是连接设计器、渲染器和后端存储的契约,一旦定下就很难大改(腾讯《前端架构设计优化:构建可扩展的低代码平台》)。
2. 渲染引擎的两种模式
渲染引擎有两种实现思路,各有取舍。
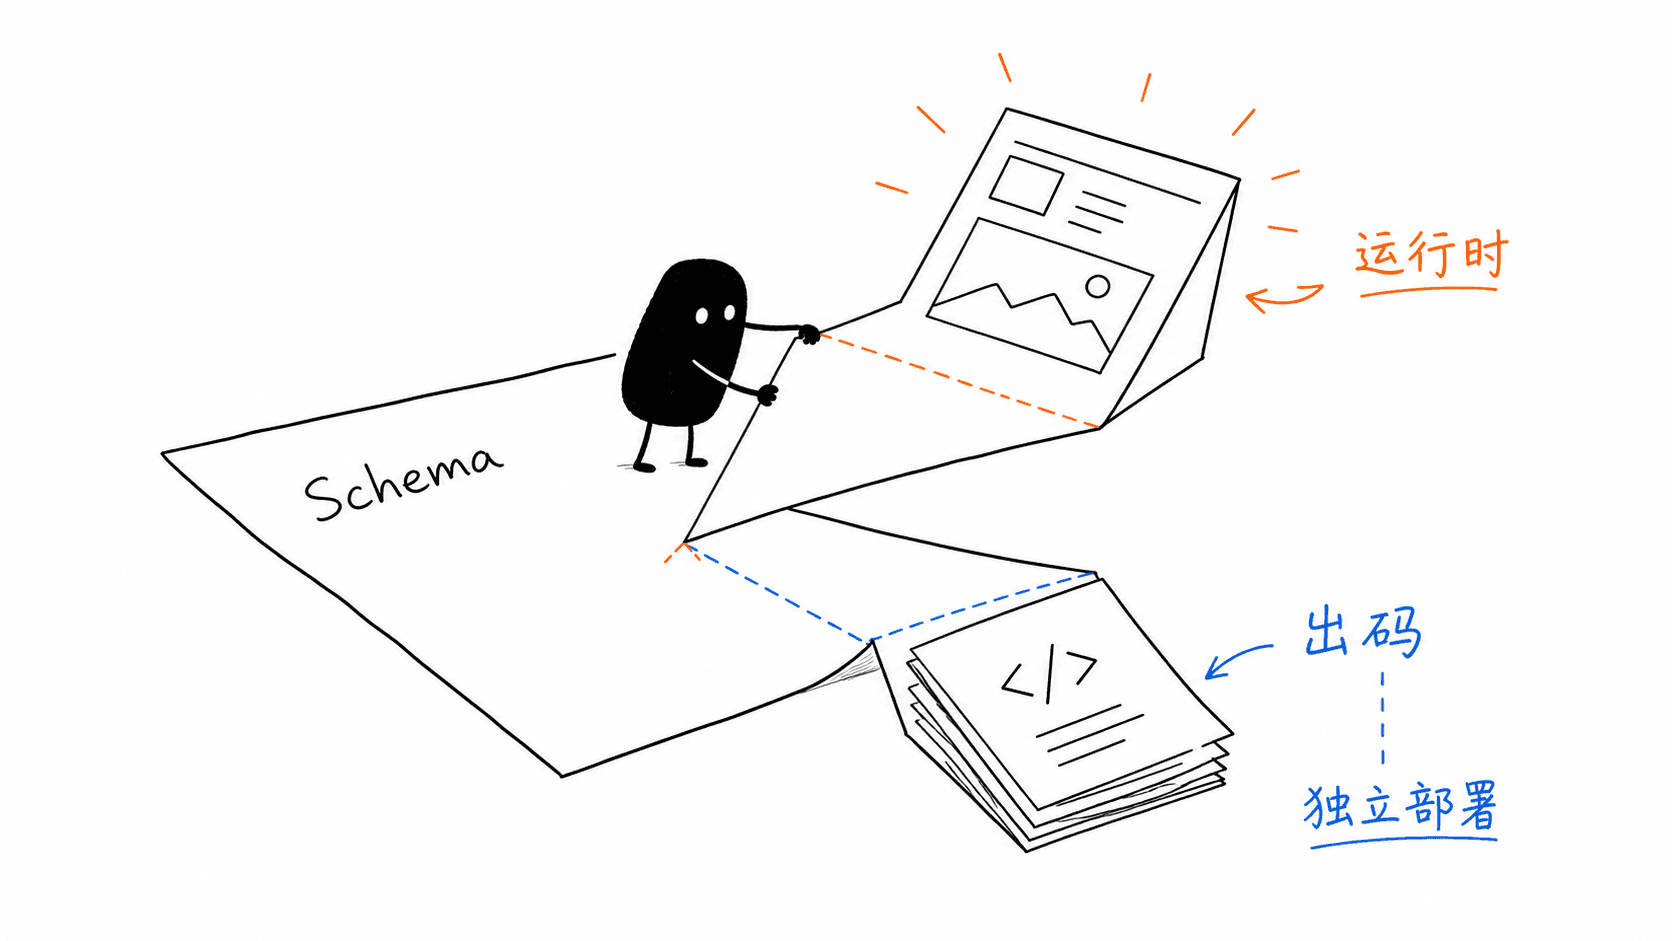
运行时渲染是最主流的方案。渲染引擎直接读取 Schema,递归遍历组件树,根据每个节点的 componentName 找到对应的组件实现并渲染,把 props 透传下去。这种方式的好处是 Schema 和页面始终同步,修改配置即时生效,非常适合设计态的实时预览。缺点是运行时承担了解析和渲染双重开销,且产出的页面依赖整个渲染引擎运行时。
出码(Code Generation)是另一种思路。它把 Schema 编译成真实的源码——比如 React 组件代码,同时分析组件依赖生成 package.json,补充工程文件,最终构建成一个可以脱离平台独立部署的 npm 包或项目(CROOT《低代码平台技术架构详解》)。出码的好处是产物性能更好、可脱离平台运行、便于二次开发;缺点是出码后修改需要重新生成,失去了运行时的灵活性。阿里的 LowCodeEngine 同时支持运行时渲染和出码两条路径,让用户按场景选择(LowCodeEngine《低代码引擎介绍》)。
实际工程中两种模式常常组合使用:设计态用运行时渲染保证实时预览,生产部署用出码获得性能和可维护性。
3. 物料体系与组件描述
物料是低代码平台的能力边界——平台能搭出什么,取决于物料库里有什么。物料的工程化要解决三个问题。
物料描述协议。每个物料需要一个描述文件,声明组件的可配置属性、属性的类型与编辑器、默认值、是否容器组件等。阿里的 LowCodeEngine 遵循《中后台前端基础构建协议规范》和《素材协议规范》,让物料可以在不同设计器间流通(LowCodeTime《阿里低代码引擎 LowCodeEngine》)。
物料的入料。已有的前端组件要接入低代码平台,需要补充描述信息并经过一层封装,把普通组件变成“低代码感知”的物料。这个过程最好自动化——通过脚手架分析组件源码和依赖,生成描述文件和构建配置(CROOT《低代码平台技术架构详解》)。
物料的版本与分发。物料通常以 npm 包形式分发,平台通过 CDN 加载。这意味着物料有版本管理问题:同一个组件的不同大版本可能 props 不兼容,页面 Schema 里需要记录物料的版本,渲染时按需加载对应版本。
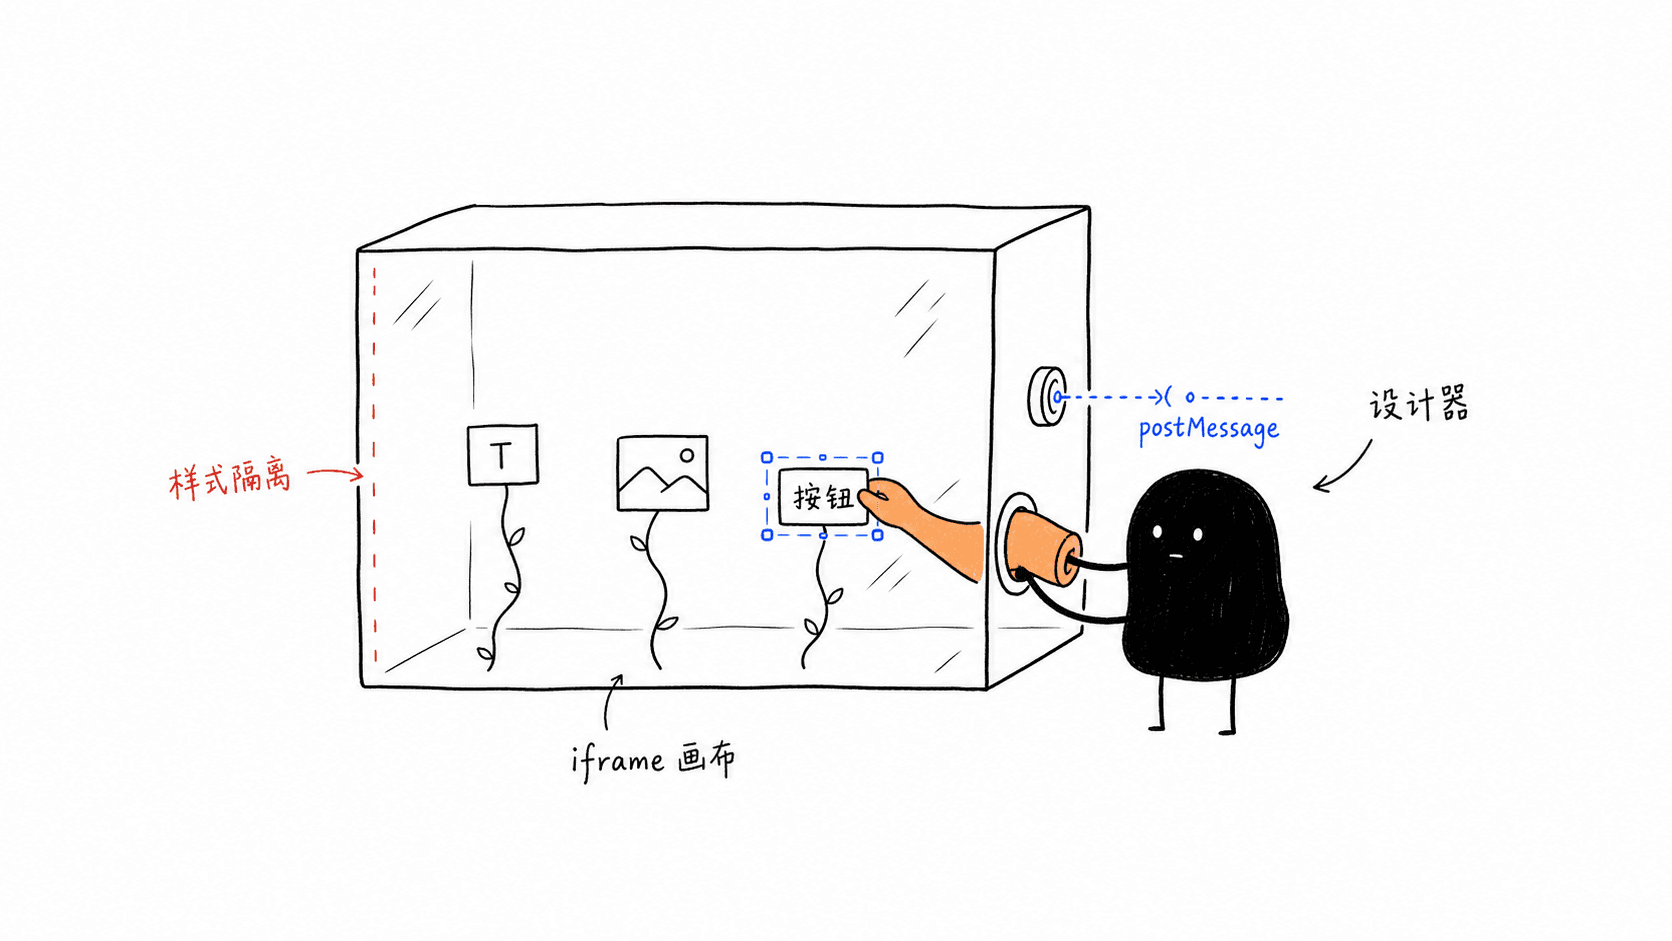
4. 设计器的画布与交互
设计器的画布是工程复杂度最高的部分,几个核心问题值得注意。
画布隔离。设计器的画布要渲染用户正在搭建的页面,但这个页面不能和设计器本身的 UI 互相干扰。常见做法是用 iframe 隔离画布,设计器通过 postMessage 和画布通信。这样画布里的组件样式、全局变量都不会污染设计器,反之亦然。阿里的 LowCodeEngine 就提供了独立的 simulator-renderer 来处理画布渲染(LowCodeEngine《低代码引擎介绍》)。
拖拽与定位。拖拽组件到画布上,需要处理落点计算、容器识别、插入位置高亮。对于自由布局(绝对定位)的画布,还要处理坐标换算、对齐辅助线、吸附。对于流式布局,核心是判断拖拽目标是哪个容器节点的哪个子节点位置。
属性联动。组件的属性之间往往有联动关系——选了某个选项,另一组属性才显示或才生效。属性配置面板需要支持条件展示、数据源联动、校验规则,这本身就是一个声明式的表单引擎问题。
5. 扩展机制:一切皆插件
一个低代码平台不可能预置所有功能,扩展能力决定了它的天花板。腾讯在架构分享中提出了“一切皆插件”的设计思路:底层实现一个 PluginDriver 和 PluginManager 管理所有插件,渲染引擎的解析器、求值器、组件渲染器都是插件,业务特有的逻辑通过扩展层的插件实现(腾讯《前端架构设计优化:构建可扩展的低代码平台》)。
阿里的 LowCodeEngine 奉行“最小内核,最强生态”的理念,内核只做最核心的协议解析和渲染调度,设计器面板、物料、工具链都通过扩展点接入(LowCodeTime《阿里低代码引擎 LowCodeEngine》)。
对前端工程师来说,扩展点通常包括:自定义物料(注册新组件)、自定义面板(往设计器加新的配置面板)、自定义工具(右键菜单、快捷操作)、setter 扩展(自定义属性编辑器)。理解一个低代码平台的扩展机制,本质上是理解它的插件契约和生命周期。
6. 数据源与逻辑编排
页面不只是静态布局,还要能取数据、做逻辑。低代码平台对这块的抽象通常分两层。
数据源管理。平台提供统一的数据源配置入口,用户声明一个数据源的请求地址、参数、返回结构,平台在运行时负责发起请求、管理 loading 状态、缓存结果。组件的属性可以绑定到某个数据源的返回字段,实现数据驱动渲染。
逻辑编排。复杂业务逻辑可以通过可视化流程图来编排,产物是 BPMN 或类似的流程描述 DSL。这种方案在节点较少、规则简单的场景下很直观,适合业务方和开发方基于流程图讨论确认;但逻辑一旦复杂,流程图的可读性反而不如代码(葡萄城《低代码平台的技术原理》)。
这也是低代码和纯代码的边界——可视化编排适合标准化的 CRUD 和流程审批,真正复杂的算法和状态管理还是应该落到代码里,通过扩展点接入平台。
四、选型与落地建议
如果你要在团队里引入或自建低代码平台,有几个判断维度值得考虑。
场景匹配。低代码最适合的是中后台管理系统、表单驱动应用、审批流场景——这些应用 UI 规律性强、交互模式可枚举、业务逻辑标准化。面向 C 端的、强交互体验的、对性能极致要求的应用,低代码的收益有限。
自建还是采用开源。阿里 LowCodeEngine 是目前国内最成熟的开源低代码引擎,适合作为自建平台的基础——它本身不是成品平台,而是帮你快速生产低代码平台的工具(LowCodeEngine《低代码引擎介绍》)。如果团队前端能力有限,直接用商业产品(如微搭、Mendix、Zoho Creator)门槛更低,但要接受平台锁定。
避免的陷阱。低代码不是银弹,它降低的是标准场景的开发成本,但一旦需求超出平台抽象能力,定制成本可能比纯代码还高。落地时建议先用低代码覆盖 80% 的标准页面,剩下 20% 的复杂场景保留代码开发的出口,而不是强行用平台硬做。